

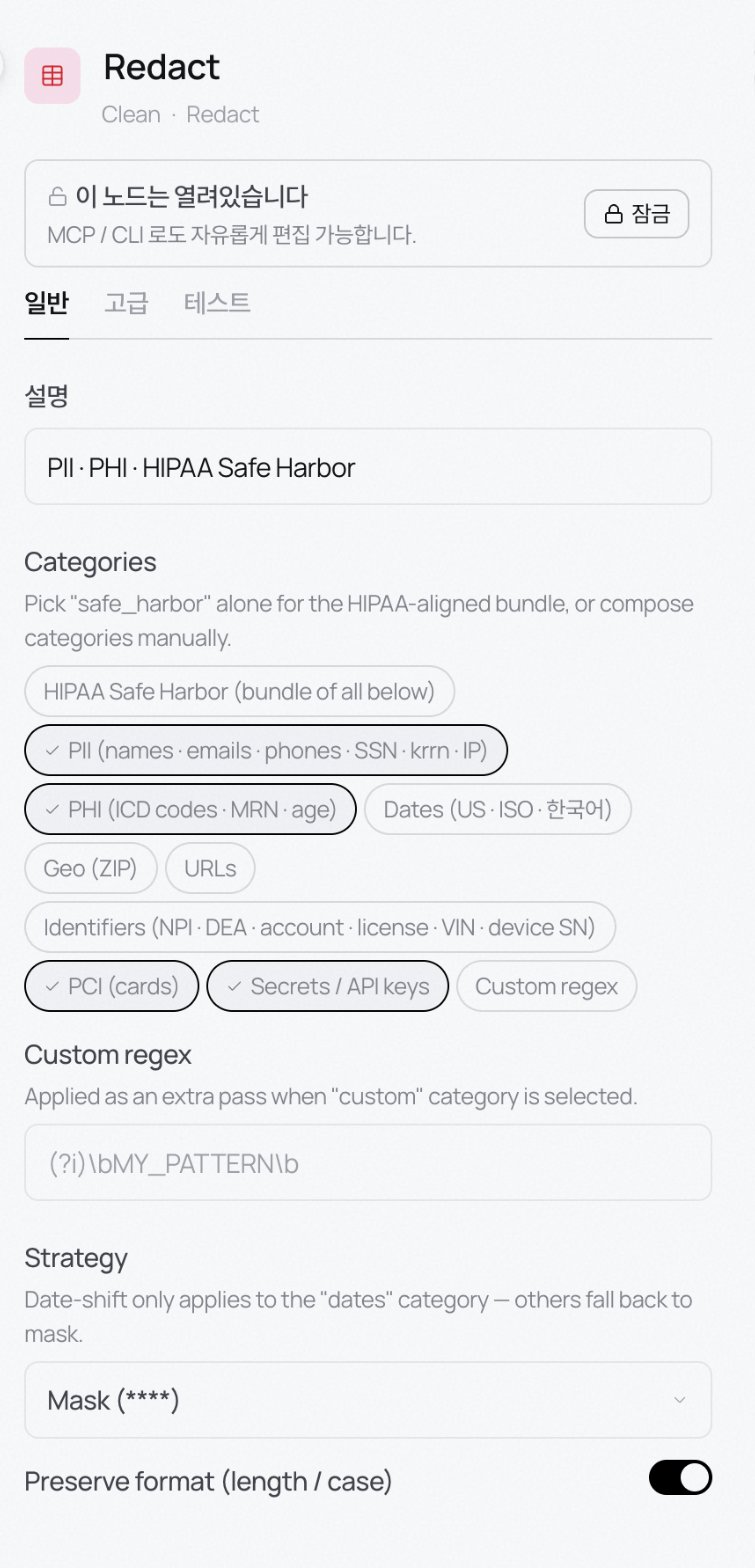
Redact
민감 정보를 찾아 가립니다. 가릴 대상은 카테고리 칩에서 선택합니다.- HIPAA Safe Harbor 아래 카테고리를 전부 묶은 번들입니다. 의료 데이터라면 이것 하나로 시작하세요.
- PII 이름, 이메일, 전화번호, SSN, 주민등록번호, IP
- PHI ICD 코드, MRN, 나이
- Dates US·ISO·한국어 날짜 형식
- Geo 우편번호 · URLs
- Identifiers NPI, DEA, 계좌번호, 면허번호, VIN, 기기 일련번호
- PCI 카드번호 · Secrets / API keys 토큰과 API 키
- Custom regex 직접 만든 패턴. custom 카테고리를 켜면 추가 패스로 적용됩니다.
****)이고, date-shift는 dates 카테고리에만 적용됩니다. Preserve format을 켜면 길이와 대소문자를 유지한 채 가려서, 형식에 민감한 후처리가 깨지지 않습니다.
Anonymize
값을 지우는 대신 다시 식별할 수 없는 형태로 바꿉니다.- Method k-anonymity(희귀 값 묶기), 결정적 해시 등
- k k-anonymity에서, 준식별자 조합이 최소 k개 행에 나타나야 통과합니다.
Normalise values
한국어 문서에서 특히 말썽인 문자·형식을 고르게 맞춥니다. 법률·약관 문서의 키워드 검색이 안 될 때 먼저 의심할 단계입니다.- NFKC 정규화 ①→1, ㈜→(주), ABC→ABC처럼 호환 문자를 표준형으로 바꿉니다.
- 한글 원문자 → 일반 ㉠→가, ㉡→나. 약관·법조항의 개요 기호를 풀어 줍니다.
- 로마숫자 → 아라비아 Ⅰ→1, Ⅱ→2. 본문의 실제 로마숫자까지 바뀌면 안 되므로 기본은 꺼져 있습니다.
- 스마트 따옴표 → ASCII 정규식·파싱을 안정화합니다.
- 공백 정리 연속 공백·탭을 단일 공백으로. 줄바꿈은 유지합니다.
- 적용 대상 날짜, 금액, 전화번호, 통화, 주소, 대소문자 중에서 선택하고, 로케일은 자동 감지가 기본입니다.