

Source 노드 종류
File
Nora에 직접 올린 문서를 씁니다. 노드가 라이브러리 폴더 하나를 가리키고, 라이브러리에서 파일을 올리고 정리하면 정제라인이 자동으로 집어 갑니다. 인스펙터의 Open in Library로 해당 폴더를 열고 Upload로 바로 올릴 수 있습니다.- Folder 기존 라이브러리 폴더를 지정합니다. 비워 두면 노드 전용 폴더를 쓰고, 노드 제목이 폴더 태그가 됩니다.
Local path
Nora 서버가 읽을 수 있는 디스크 경로에서 가져옵니다. 단일 호스트나 개발 환경이면 그대로 쓰면 되고, 호스트가 여럿인 운영 환경이면 그 경로가 Nora 호스트에 마운트되어 있어야 합니다.- Path 러너가 읽을 수 있는 절대 경로(예:
/data/inbox) - Library folder 추출한 문서가 들어갈 라이브러리 폴더. 비우면 Inbox
- Accepted MIME PDF, PNG, JPEG, TIFF, DOC, DOCX, TXT, Markdown 중 선택
- Max file size 파일당 크기 상한(MB)
Object
S3, GCS, Azure Blob 같은 오브젝트 스토리지에서 가져옵니다.- Provider Amazon S3 등
- Bucket / container 대상 버킷
- Key prefix이 접두사 아래 오브젝트만 나열합니다. 비우면 버킷 전체
- Max objects per run 실행 한 번에 나열할 오브젝트 상한
- Max download size 이보다 큰 오브젝트는 본문 없이 메타데이터와
data_too_large: true만 내보냅니다. 0이면 본문을 아예 받지 않습니다.
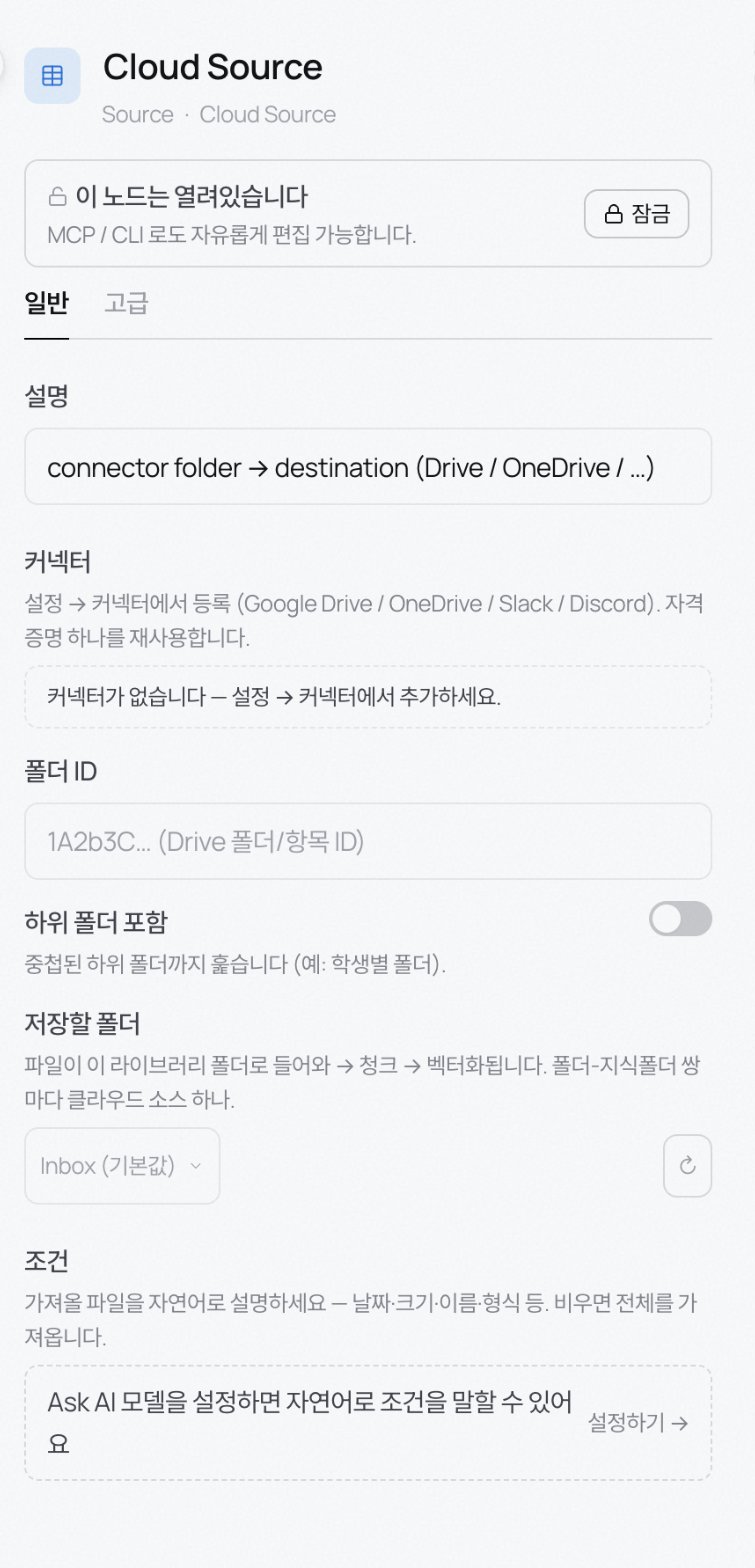
Cloud Source
커넥터로 연결한 클라우드 폴더(Google Drive, OneDrive 등)를 지식 폴더와 짝지어 가져옵니다.- 커넥터 설정 → 커넥터에서 등록한 자격증명을 선택합니다(커넥터 참고).
- 폴더 ID 가져올 드라이브 폴더나 항목의 ID
- 하위 폴더 포함 중첩된 하위 폴더까지 훑습니다.
- 저장할 폴더 파일이 들어갈 라이브러리 폴더. 폴더와 지식 폴더 한 쌍마다 Cloud Source 노드을 하나 둡니다.
- 조건 가져올 파일을 자연어로 지정합니다(날짜·크기·이름·형식 등). Ask AI 모델을 설정해야 쓸 수 있고, 비우면 전체를 가져옵니다.
Web / API
HTTP GET/POST로 아무 REST API에서나 가져옵니다. Slack, Notion, GitHub, Gmail처럼 API가 있는 서비스라면 무엇이든 대상입니다.- 엔드포인트 메서드와 URL. cURL에서 가져오기로 cURL 명령을 붙여 넣으면 필드가 채워집니다.
- 헤더 · 파라미터 필요한 만큼 추가합니다.
Stream
Kafka 토픽을 배치로 읽어 옵니다. Schedule 트리거와 짝지어 주기적으로 폴링하는 구성이 기본입니다. 지금은 Kafka만 지원합니다.- Bootstrap servers 쉼표로 구분합니다.
secrets://<ENV>를 쓰면 환경 변수에서 읽습니다. - Topic · Consumer group 같은 group_id를 쓰는 정제라인 인스턴스는 파티션을 나눠 갖고, group_id가 다르면 각자 전체 스트림을 받습니다.
- Start offset 새 컨슈머 그룹의 첫 실행에만 적용됩니다. 이후 실행은 커밋된 오프셋에서 이어 갑니다.
- Max messages per run 실행 한 번에 읽을 메시지 상한
- Poll timeout 첫 메시지를 기다리는 시간. 빈 토픽이면 이 시간 뒤에 바로 돌아옵니다.
Database
Postgres, MySQL, MariaDB 테이블을 커서 기준으로 폴링합니다. Schedule 트리거와 짝지어 씁니다. 인스펙터는 DB 선택 + SQL 에디터 셸로, Enrich · DB Lookup / Output · DB Upsert 와 같은 모양을 씁니다.- DB 선택 설정 → 내부 리소스에 등록해 둔 SQL 데이터베이스를 고릅니다. DSN 을 정제라인 JSON 에 남기지 않고 참조로만 씁니다.
- SQL
{{cursor}}와{{limit}}자리표시자를 쓴 쿼리를 씁니다. 자리표시자는 엔진의 바인드 파라미터로 매핑되고, 문자열로 끼워 넣지 않습니다. 대개SELECT * FROM <table> WHERE updated_at > {{cursor}} ORDER BY updated_at ASC LIMIT {{limit}}같은 모양입니다. - 커서 · 배치 (고급 탭)
Cursor type(timestamp/integer/string),Initial cursor,Max rows per run을 여기서 정합니다. - 레거시 자동 빌더 (고급 탭)
Table·Cursor column·Extra WHERE를 채우면 위의 SQL 에디터가 비어 있을 때만 쿼리를 자동으로 조립합니다. 예전 정제라인 호환용입니다.