

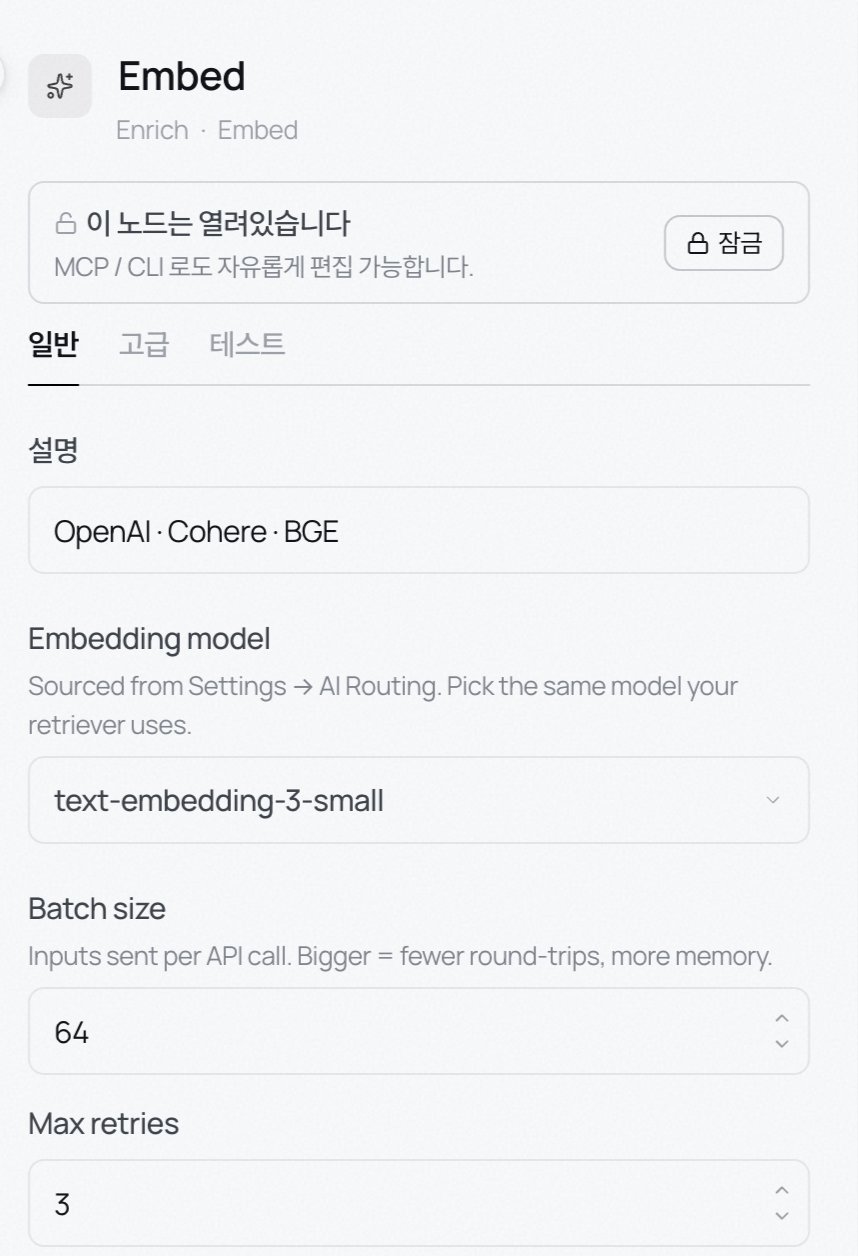
Embed
청크 텍스트를 벡터로 바꿉니다. 임베딩이 의미 검색을 가능하게 합니다. 공간에서 가까운 벡터가 서로 더 관련 있죠.- Embedding model Settings → AI Routing에 등록된 모델 중에서 선택합니다. 리트리버가 쓰는 모델과 같은 것을 선택하세요. 임베딩과 검색이 다른 모델을 쓰면 검색이 되지 않습니다.
- Batch size 기본 64. API 호출 한 번에 보내는 입력 수입니다. 크면 왕복이 줄고 메모리를 더 씁니다.
- Max retries 기본 3
Contextual prep
임베딩 전에 청크마다 문서 맥락 한 조각을 붙입니다(Anthropic의 Contextual Retrieval 방식). 청크 하나가 추론 호출 하나를 쓰므로 작은 모델로 시작하세요.- Max context tokens 50~100 권장. 길수록 맥락은 풍부해지고 임베딩 입력은 커집니다.
- Include doc title 문서 제목을 청크마다 앞에 붙입니다. 문서가 여럿 섞일 때 구분에 좋습니다.
- Use prompt caching 문서 본문을 호출 간에 재사용해 비용을 크게 줄입니다.
NER
이름 붙은 엔티티를 찾아 붙입니다. Entity types에서 PERSON, ORG, MONEY, DATE, GPE(위치), PRODUCT, EVENT를 선택하고, Min confidence 아래 점수는 버립니다. “Acme Corp가 나온 청크를 다 보여줘” 같은 검색형 쿼리에 좋습니다.Classifier
청크마다 라벨 하나를 선택합니다. Kind는 topic·sentiment·intent·risk 중에서 선택하고, 라벨 목록을 쉼표로 나열하면 LLM이 그중 정확히 하나를 답합니다. Min confidence 아래 점수는 버립니다. 라벨은 청크에 메타데이터로 남습니다(태그 참고).HTTP Lookup
레코드마다 외부 API를 조회해 응답 JSON을 붙입니다.- URL template
{{record.<필드>}}를 URL 에 그대로 끼워 넣습니다. 예:https://api.example.com/users/{{record.user_id}}. - Method GET 또는 POST.
- Auth None · Bearer · Basic · OAuth2 중에서 선택. Bearer 는
secrets://<ENV>로 시크릿 참조를 씁니다. - Attach to field 응답이
record.<필드>로 들어갑니다. - On failure null 을 붙이고 계속(Attach null) · 레코드 버림(Drop record) · 실패 처리(Fail record) 중에서 선택.
- Cache TTL 같은 조회를 캐시합니다. 0이면 캐시하지 않습니다.
DB Lookup
레코드마다 데이터베이스에서 한 행을 찾아 붙입니다. Postgres, MySQL, MariaDB를 지원합니다. 인스펙터는 Source · Database / Output · DB Upsert 와 같은 DB 선택 + SQL 에디터 셸을 씁니다.- DB 선택 설정 → 내부 리소스에 등록해 둔 SQL 데이터베이스를 고릅니다. DSN 을 정제라인 JSON 에 남기지 않습니다.
- SQL
{{record.<경로>}}를 쓴 쿼리를 씁니다. 자리표시자는 엔진의 바인드 파라미터로 매핑되고, 옆 패널에 SQL 에서 뽑아낸 바인딩이 표시됩니다. 위치 자리표시자를 직접 쓰지 마세요. - Attach to field · On no match · Cache TTL HTTP Lookup과 같습니다.
LLM Tagger
프롬프트로 정의한 라벨을 레코드마다 답니다.- 모델 비우면 워크스페이스 기본 모델
- 시스템 프롬프트 · 사용자 템플릿 템플릿은 레코드마다 렌더링되고
{{record.<필드>}}로 값을 참조합니다. - 저장 필드 파싱된 라벨을 넣을 JSON 키. 비우면 레코드 최상위로 병합합니다.
- 최대 비용 · 최대 토큰 지출 상한을 겁니다.
Script
레코드마다 짧은 JavaScript나 Python 함수를 돌려 원하는 필드를 계산해 붙입니다.record.<필드>에 통째로 넣습니다.
공통
- Contextual prep, NER, Classifier 등 LLM을 쓰는 노드는 인스펙터의 테스트 탭에서 샘플로 바로 시험할 수 있습니다.
- Enrich 노드는 이은 순서대로 돕니다. 앞 노드가 붙인 필드를 뒤 노드의 입력으로 쓸 수 있습니다.
- LLM 호출과 임베딩은 비용이 쌓이는 곳입니다. 작은 모델로 시작하고, LLM Tagger의 최대 비용·최대 토큰으로 상한을 거세요.
- 워크스페이스에 버티컬 프로파일 (보험·의료·SaaS) 이 켜져 있으면 팔레트에 Clause tagger, Compliance, Risk scorer, ICD coder, CPT/HCPCS, LOINC mapper, RxNorm, Negation, Temporal norm, Clinical sections 같은 도메인 노드가 추가로 뜹니다.